01 / Question & constat
La précision sur des images propres ne dit pas comment le modèle réagit à une perturbation conçue pour le tromper.
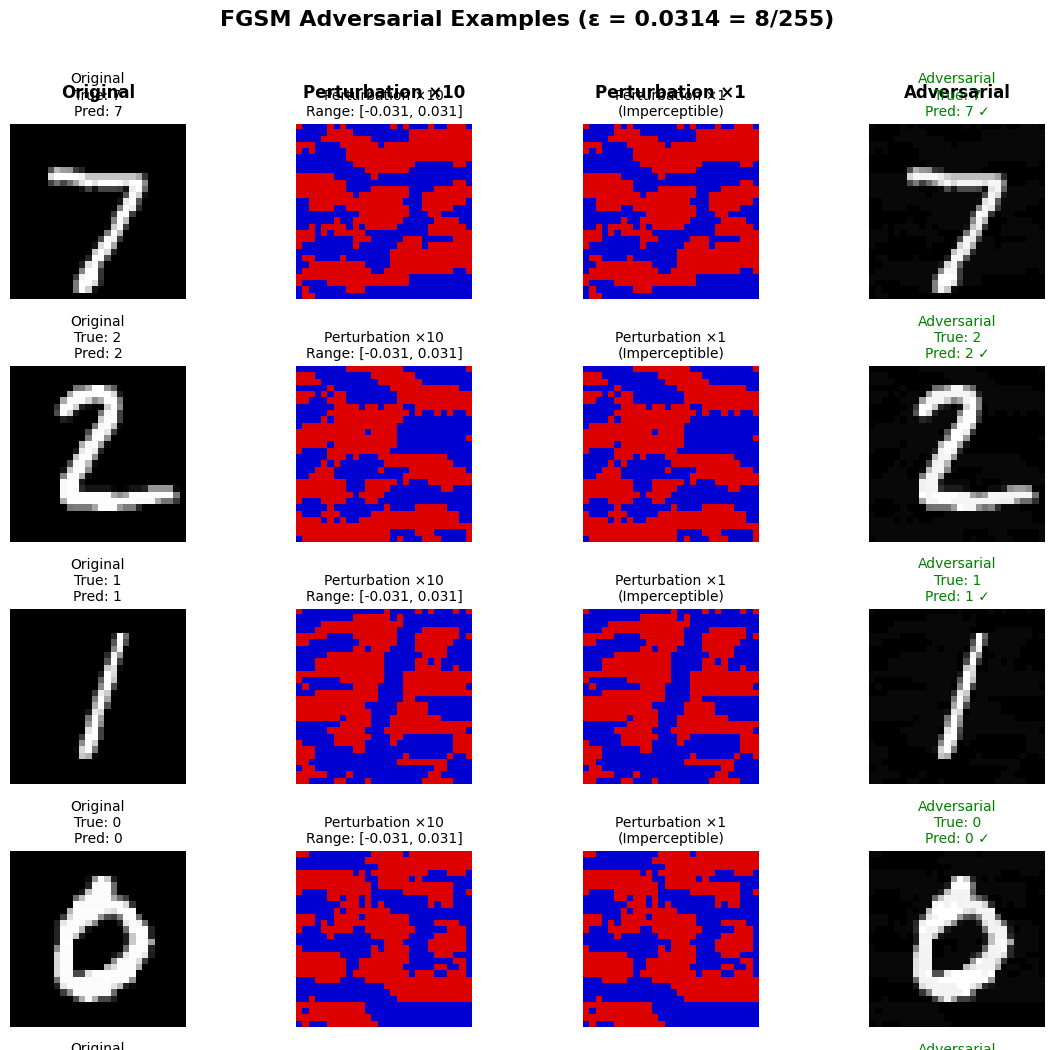
Le projet part d’un CNN MNIST précis à 99 % et pose une question simple. Une modification presque invisible des pixels suffit-elle à changer sa décision ? Et l’entraînement adversarial réduit-il ce risque sans dégrader la précision normale ? Un exemple adversarial est justement une entrée modifiée de façon volontaire pour provoquer une erreur du modèle tout en restant visuellement très proche de l’original.
Précision sur les images propres : le point de départ est déjà très performant.
La robustesse baisse sous attaque, ce qui confirme qu’une bonne exactitude sur données propres ne suffit pas à décrire le comportement du modèle.
L’entraînement adversarial récupère 0,90 point de robustesse tout en maintenant la précision propre à 99,13 %.
Ce que l’expérience révèle : la défense fonctionne dans ce protocole, mais le gain absolu reste modeste. Le taux de succès de l’attaque passe de 2,07 % à 1,29 % à ε=8/255, soit −0,78 point, même si la baisse relative est d’environ 38 %.
02 / Configuration
Une expérience cadrée avec paramètres fixes et artefacts sauvegardés.
MNIST
60 000 images d’entraînement et 10 000 images de test.
CNN · 3 274 634 paramètres
Deux convolutions, deux couches entièrement connectées et dropout.
03 / Expérience
Le même protocole permet de comparer le modèle avant et après défense.
FGSM (Fast Gradient Sign Method) utilise le gradient du modèle pour modifier chaque pixel dans une limite ε. Ici, ε vaut 2/255, 4/255 ou 8/255 : plus ε augmente, plus l’attaquant peut perturber l’image.
Mesurer la référence
Entraîner le CNN cinq époques sur des images propres, puis mesurer sa précision normale.
Tester sous attaque
Générer des exemples FGSM aux trois niveaux ε et mesurer la perte de précision.
Renforcer puis retester
Réentraîner huit époques avec 50 % d’images propres et 50 % d’exemples adversariaux à ε=8/255, puis rejouer exactement les mêmes tests.
04 / Résultats & interprétation
Le modèle renforcé est plus robuste à chaque niveau d’attaque, sans sacrifier la précision propre.
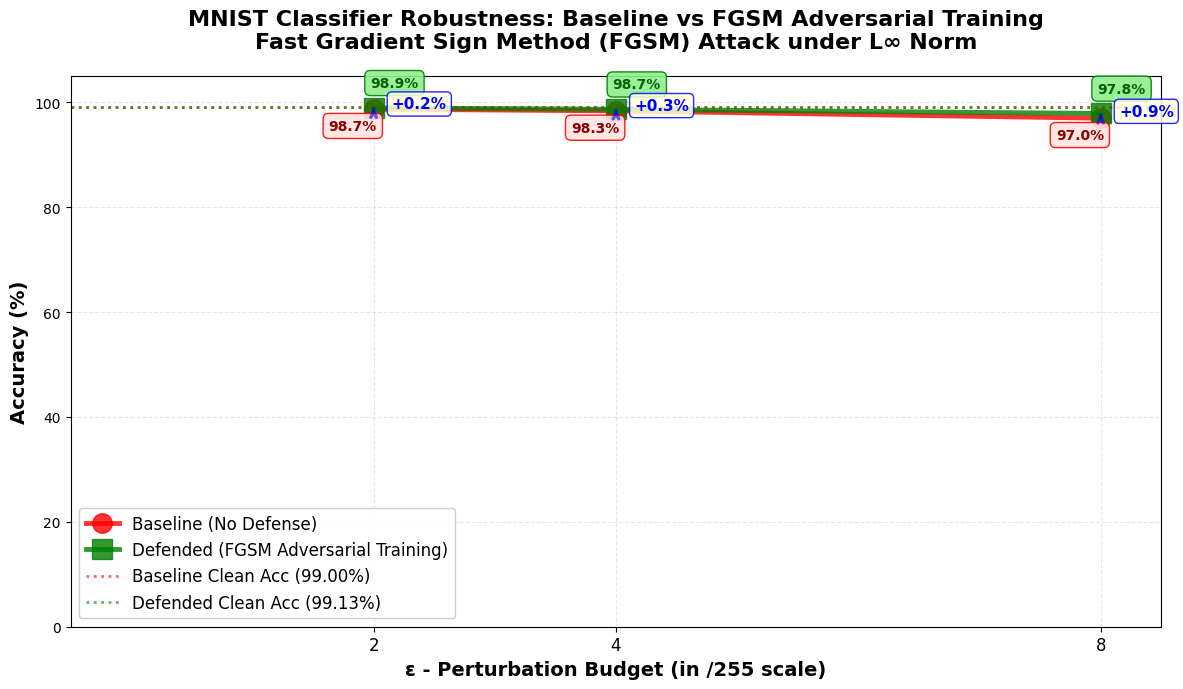
Le résultat important n’est donc pas « le modèle devient invulnérable ». Il montre plutôt qu’une exposition contrôlée aux exemples adversariaux améliore la résistance à FGSM, surtout au niveau de perturbation le plus fort testé, sans créer de compromis visible sur la précision propre. Côté sécurité, l’expérience rappelle qu’une bonne exactitude (accuracy) standard ne suffit pas : il faut aussi tester comment le modèle réagit à des entrées conçues pour le tromper.
05 / Reproductibilité
Les paramètres, modèles, résultats et graphiques ont été sauvegardés.
Les paramètres, modèles, résultats et graphiques utilisés pour l’évaluation ont été conservés dans les artefacts du projet. Les contrôles incluent la borne L∞, la disponibilité des gradients et une inspection visuelle des perturbations. Le dépôt public sera ajouté après récupération, nettoyage et vérification du code source.
06 / Limites
FGSM est un bon premier test, pas une évaluation complète de robustesse.
Des attaques itératives plus fortes comme PGD et une suite telle qu’AutoAttack sont nécessaires avant toute conclusion générale.
Les résultats ne se transposent pas automatiquement à des images complexes ou à un modèle de production.
07 / Conclusion
L’expérience montre une amélioration réelle, mais limitée au protocole testé.
Le CNN de départ était déjà robuste sur MNIST. L’entraînement adversarial améliore encore ce comportement, mais le gain absolu reste inférieur à un point de précision sous FGSM à ε=8/255.
Une mesure de robustesse doit toujours préciser l’attaque, son intensité et le compromis avec la performance normale. Ici, la conclusion est utile parce qu’elle reste bornée : FGSM sur MNIST valide une démarche expérimentale, pas une robustesse générale face à toutes les attaques adversariales.