01 / Contexte & question
Un filtre anti-spam a deux façons d’échouer, et elles n’ont pas le même coût.
Chaque SMS reçu doit être classé ham (message légitime) ou spam (message indésirable : promotions, faux gains, numéros surtaxés).
Un filtre peut laisser passer un spam : c’est gênant. Il peut aussi bloquer un vrai message, par exemple un rendez-vous ou un code de connexion : c’est beaucoup plus grave pour l’utilisateur. Toute la suite du projet est donc construite pour mesurer ces deux erreurs séparément, et pas seulement un pourcentage global de bonnes réponses.
Sur ce jeu de données SMS, un modèle qui suit l’ordre des mots fait-il vraiment mieux qu’une méthode classique beaucoup plus simple ?
Avant de choisir un modèle, il fallait d’abord savoir à quoi ressemblent ces messages.
02 / Exploration des données (EDA)
L’exploration montre trois choses qui orientent toute la suite : déséquilibre, doublons, et un style propre au spam.
L’analyse exploratoire (EDA) consiste à regarder les données avant de modéliser : combien de messages, quelle proportion de spam, quelles anomalies, quelles différences visibles entre les deux classes. Elle sert à prendre les bonnes décisions de préparation et d’évaluation.
- compté les messages de chaque classe et cherché les valeurs manquantes ;
- cherché les messages en double ;
- comparé la longueur des messages ham et spam ;
- listé les mots les plus fréquents de chaque classe.
4 825 ham et 747 spam, aucune valeur manquante.
Retirés avant tout découpage.
4 516 ham et 641 spam.
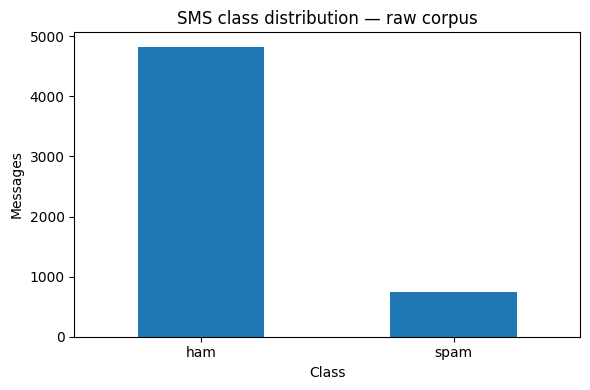
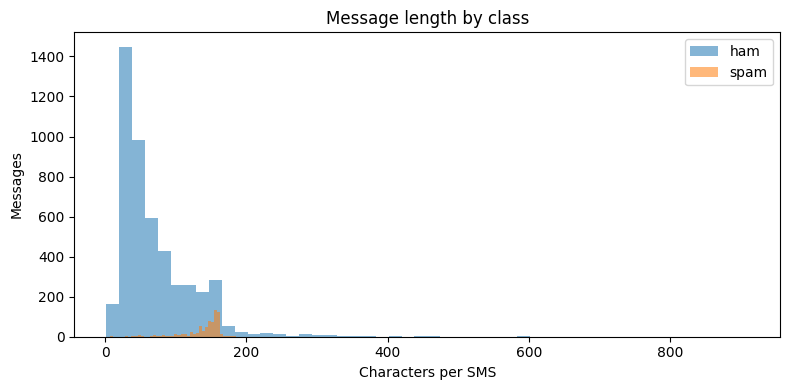
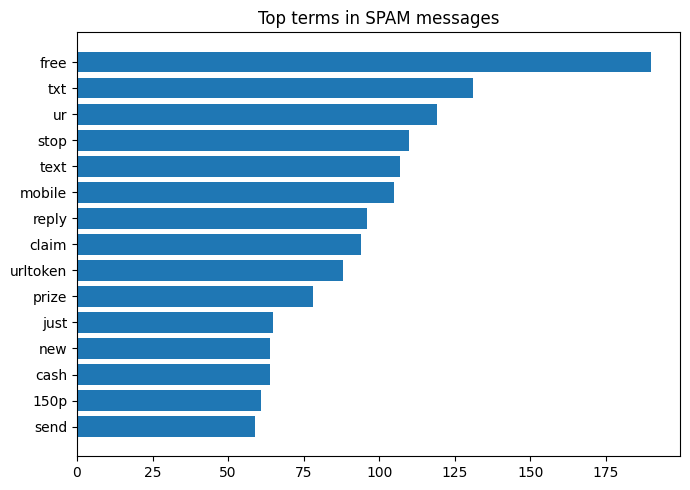
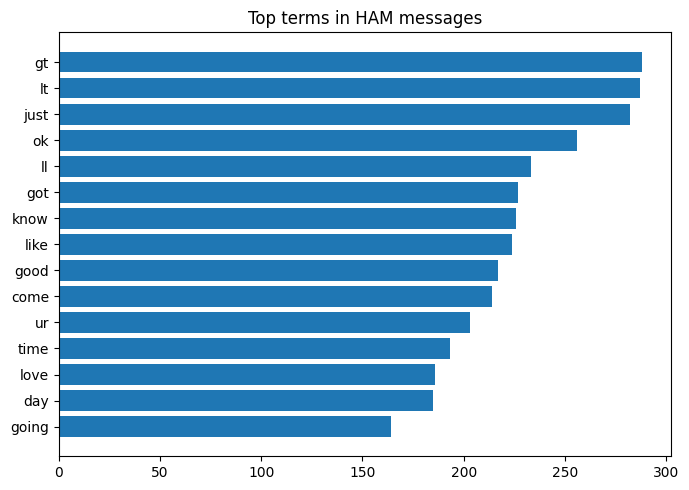
Le déséquilibre impose de suivre la précision et le rappel sur le spam plutôt que l’exactitude. Les doublons doivent être retirés avant le découpage, sinon un même message pourrait être appris puis « reconnu » au test. Les liens et le vocabulaire commercial montrent qu’il ne faut pas effacer ces indices au nettoyage.
Ces observations ont directement guidé la façon de préparer le texte.
03 / Préparation du texte
Un nettoyage volontairement léger, pour garder les indices utiles au filtre.
- passage en minuscules (« FREE » et « free » deviennent le même mot) ;
- remplacement de chaque lien par le mot
urltoken: l’adresse exacte change d’un spam à l’autre, mais la présence d’un lien est un signal ; - suppression de la ponctuation et des espaces multiples ;
- codage des étiquettes : ham = 0, spam = 1.
Je n’ai pas supprimé les mots courts ni les chiffres : dans les SMS, « txt », « 150p » ou un numéro court sont justement typiques du spam, comme l’a montré l’exploration.
Une fois les messages préparés, il fallait organiser l’évaluation avant d’entraîner quoi que ce soit.
04 / Découpage apprentissage, validation, test
Trois jeux de messages séparés, chacun avec un rôle précis.
Le vocabulaire du BiLSTM et les poids TF-IDF sont appris uniquement sur les 3 609 messages d’apprentissage. Sinon, des mots présents seulement dans le test influenceraient le modèle, et le résultat serait trop optimiste.
Avec ce cadre en place, j’ai pu entraîner deux approches très différentes dans les mêmes conditions.
05 / Deux modèles, deux façons de lire un SMS
Un modèle qui suit l’ordre des mots, face à une méthode qui pèse les mots importants.
A · BiLSTM
B · TF-IDF + régression logistique
- chaque SMS est ramené à 33 mots : la longueur de 95 % des messages d’apprentissage (les plus courts sont complétés, les plus longs coupés) ;
- des poids de classe donnent plus d’importance aux erreurs sur le spam, minoritaire ;
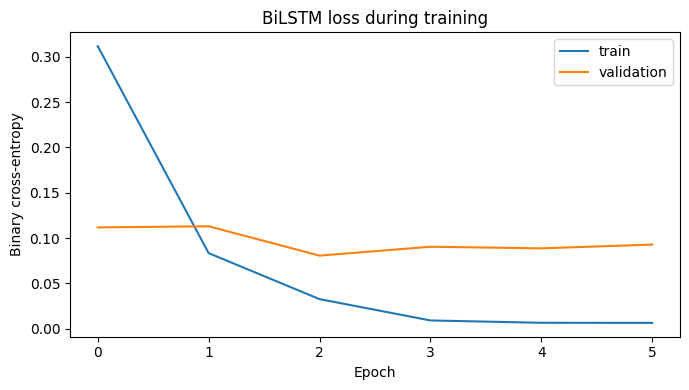
- l’entraînement s’arrête quand l’erreur sur la validation ne baisse plus (arrêt anticipé), avant que le modèle n’apprenne par cœur.
Les deux modèles produisent une probabilité ; restait à décider à partir de quand un message est déclaré spam.
06 / Choix du seuil de décision
Le seuil décide du compromis entre spams laissés passer et vrais messages bloqués.
J’ai testé les seuils sur le jeu de données de validation et gardé celui qui donne le meilleur F1 spam : 0,83 pour le BiLSTM et 0,56 pour TF-IDF + régression logistique. Le seuil élevé du BiLSTM suggère des probabilités très tranchées sur les spams nets : il peut exiger une forte certitude avant de bloquer.
Les deux seuils ont été figés avant la moindre évaluation sur le jeu de données de test, pour que le résultat final ne soit pas ajusté sur les messages servant à le mesurer.
Les modèles et leurs seuils étant fixés, le jeu de données de test pouvait enfin être utilisé.
07 / Résultats sur le test
Le BiLSTM gagne, mais d’une courte tête.
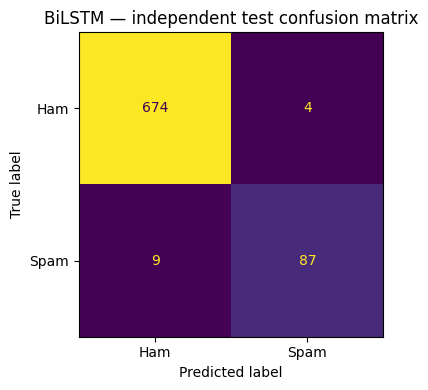
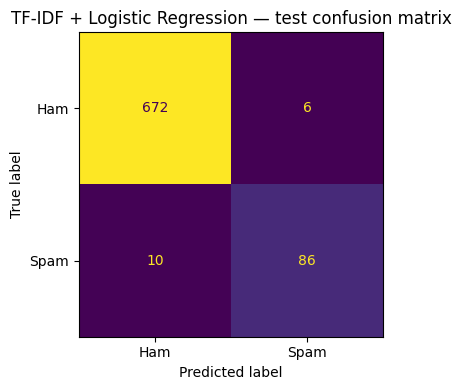
Le jeu de données de test contient 774 messages : 678 vrais messages et 96 spams.
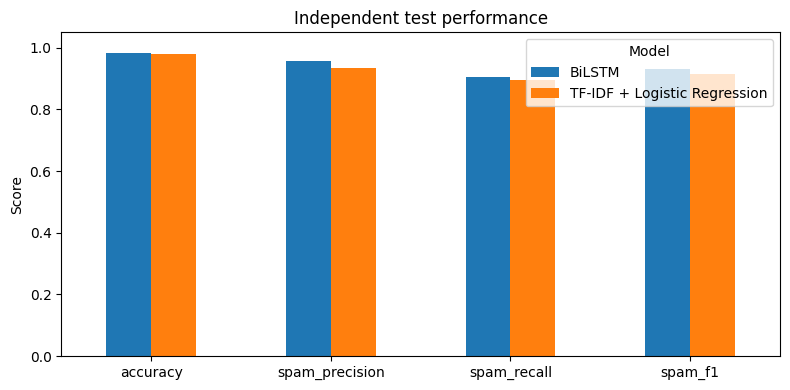
Ces chiffres sont proches ; la vraie question devient : lequel choisir, et pourquoi ?
08 / Interprétation & valeur réelle
Le meilleur score ne désigne pas toujours le meilleur choix en production.
Le BiLSTM bloque deux vrais messages de moins et arrête un spam de plus : c’est le meilleur classifieur de l’expérience. Mais la méthode TF-IDF reste très proche, et elle obtient même des aires sous les courbes ROC et précision-rappel légèrement supérieures, c’est-à-dire un classement des messages tout aussi bon quand on fait varier le seuil.
Le BiLSTM si chaque vrai message bloqué compte ; TF-IDF si la vitesse, la simplicité de mise à jour et l’explicabilité priment, puisqu’on peut lire directement les mots qui pèsent sur la décision.
Avec 13 erreurs sur 774 messages, le BiLSTM se trompe rarement. Mais 9 spams sur 96 passent encore, soit près d’un sur dix : c’est là que des données plus récentes ou un modèle plus riche auraient le plus d’effet.
Reste à être clair sur ce que cette expérience prouve, et sur ce qu’elle ne prouve pas.
Décision : le BiLSTM est le meilleur classifieur testé, mais l’écart est suffisamment faible pour que TF-IDF + régression logistique reste un choix crédible lorsque simplicité, vitesse et explicabilité comptent davantage.
09 / Limites & apprentissages
Un résultat solide sur ce jeu de données SMS, à confirmer sur des SMS récents.
- Jeu de données SMS (corpus) ancien et anglophone : le vocabulaire du spam a évolué.
- Apprentissage et test viennent de la même source : pas de validation sur un autre jeu de données.
- Pas de mesure de vitesse ni de mémoire, qui compteraient pour un déploiement.
Comparer un modèle complexe à une méthode simple, avec le même découpage et un seuil choisi en validation, est plus instructif qu’un score isolé. Ici, le BiLSTM gagne, mais l’écart faible montre surtout qu’un modèle plus complexe n’est utile que si son gain justifie son coût d’exploitation.
Pour aller plus loin
Prochaines étapes envisagées : tester sur un jeu de données de SMS récents, essayer un modèle de type transformer et régler le seuil selon le coût réel de chaque erreur. Le notebook détaille chaque étape et ses résultats.