01 / Contexte & question
Un fragment de verre peut orienter une enquête, à condition de savoir de quel verre il s’agit.
Chaque échantillon est décrit par son indice de réfraction (RI) et sa teneur en huit éléments : sodium (Na), magnésium (Mg), aluminium (Al), silicium (Si), potassium (K), calcium (Ca), baryum (Ba) et fer (Fe). Il faut prédire son type parmi six.
La nomenclature prévoit sept types, mais aucun échantillon de vitre de véhicule non-float (Type 4) n’existe dans les données : le problème compte donc six classes.
Avec si peu d’échantillons, quel modèle classe le mieux les six types, et lesquels restent difficiles à distinguer ?
Avant de comparer des modèles, il fallait comprendre la forme de ces 214 mesures.
02 / Ce que les données montrent avant le modèle
Le baryum distingue surtout les phares, alors que plusieurs types de vitres restent chimiquement proches.
Les fragments de phares présentent des niveaux de baryum nettement plus élevés.
Les contenants et phares présentent peu de magnésium par rapport à plusieurs vitres de bâtiment.
Leurs compositions se recouvrent davantage, ce qui annonce les erreurs observées plus tard dans la matrice de confusion.
Conséquence : l’EDA ne sert pas seulement à préparer le modèle. Elle explique déjà pourquoi certaines classes seront faciles à reconnaître et d’autres beaucoup plus ambiguës.
03 / Exploration des données (EDA)
L’exploration révèle un jeu de données très réduit, très déséquilibré, avec des valeurs extrêmes qui sont peut-être réelles.
L’analyse exploratoire (EDA) consiste à examiner les données avant toute modélisation : effectifs, doublons, distributions, valeurs extrêmes et différences visibles entre classes. Ici, elle détermine à la fois la façon d’évaluer les modèles et ce qu’on peut attendre d’eux.
- valeurs manquantes et doublons ;
- nombre d’échantillons par type ;
- distribution de chaque mesure et valeurs extrêmes ;
- corrélations entre mesures ;
- profils chimiques qui distinguent certains types.
214 lignes, un doublon exact retiré.
Type 2, vitres non-float.
Type 6, vaisselle.
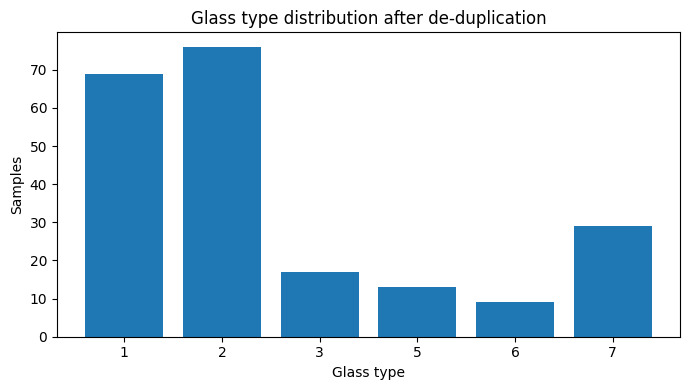
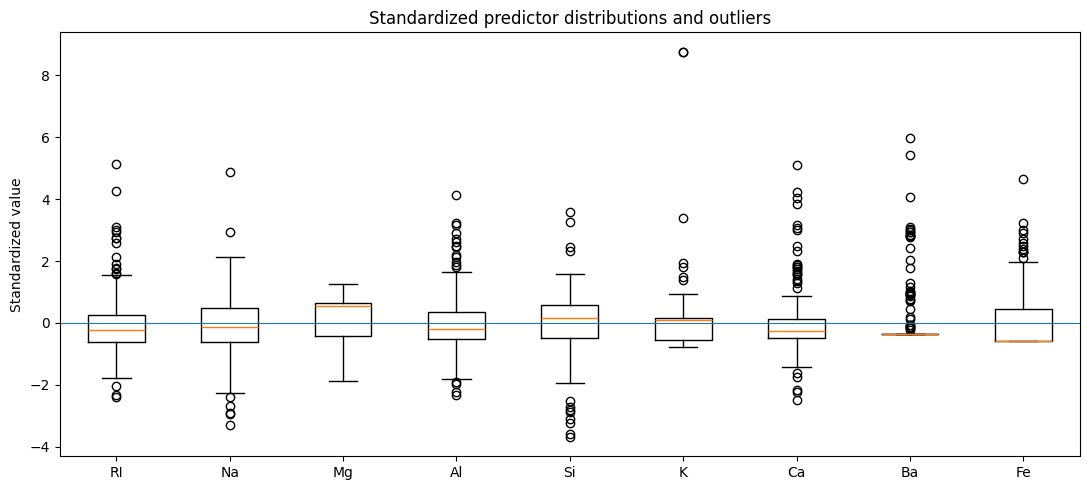
J’ai gardé les valeurs extrêmes : dans un jeu de données aussi petit, un taux de baryum élevé peut décrire une vraie composition (par exemple un verre de phare) et non une erreur de mesure.
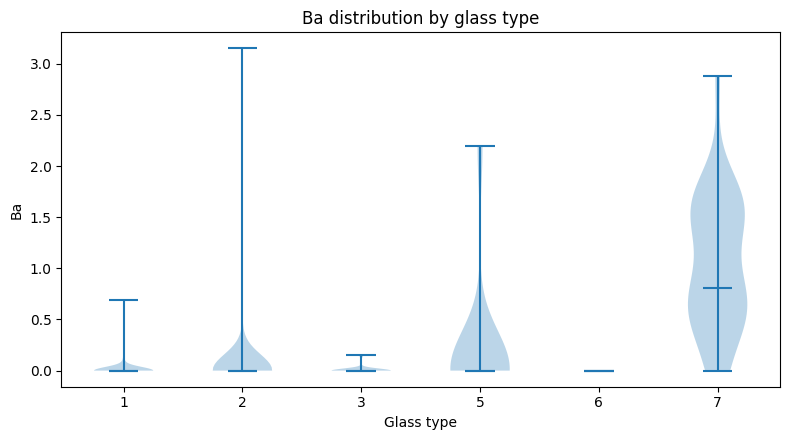
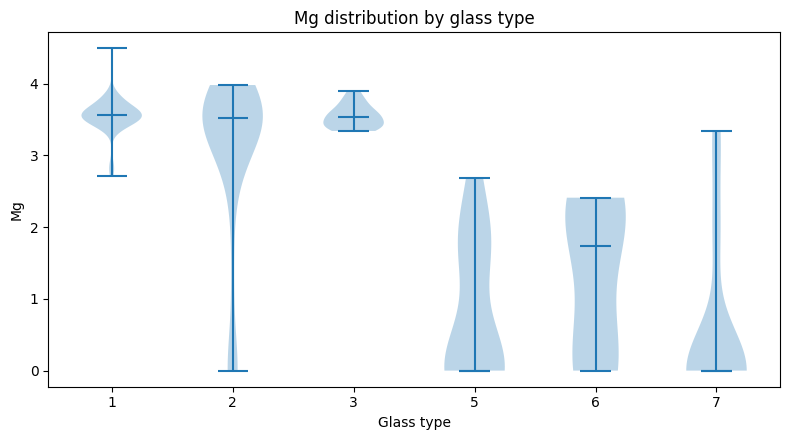
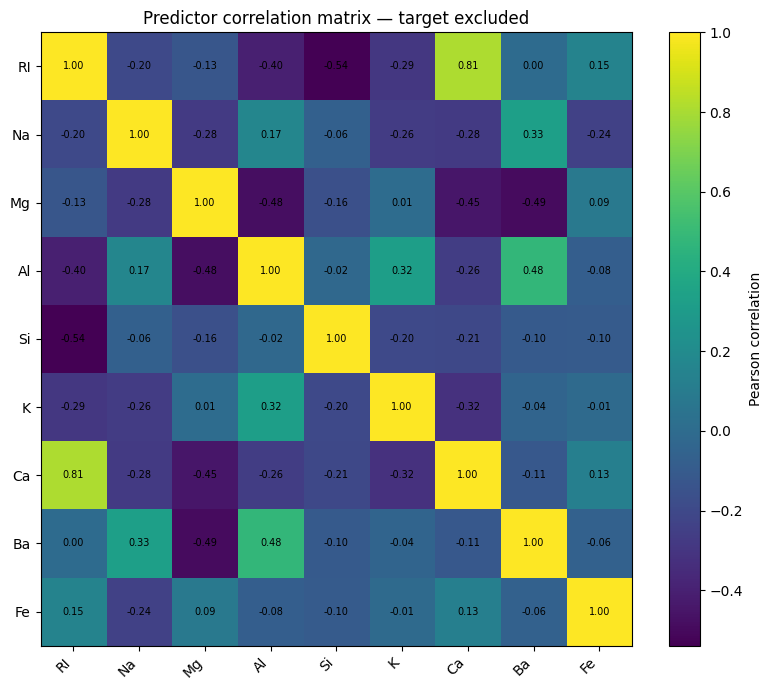
Le petit effectif rend un seul découpage apprentissage/test trop fragile : 9 échantillons de vaisselle peuvent tomber presque tous du même côté. Le déséquilibre impose une métrique qui donne du poids aux petites classes. Et les profils chimiques laissent prévoir que phares et contenants seront plus faciles que les vitres entre elles.
Le premier choix de méthode découle directement du petit nombre d’échantillons : la façon d’évaluer.
04 / Évaluer avec la validation croisée
Cinq rotations plutôt qu’un seul découpage chanceux.
Ce cadre impose une règle stricte pour toutes les étapes de préparation : elles doivent se faire à l’intérieur de chaque pli.
05 / Préparer les données dans chaque pli
Normaliser et rééquilibrer, sans jamais toucher aux échantillons évalués.
Si la normalisation ou SMOTE utilisaient aussi le groupe évalué, des informations de ce groupe entreraient dans l’apprentissage, et le score serait artificiellement bon. Les échantillons évalués restent donc toujours de vrais échantillons, jamais vus.
Une fois ce protocole fixé, je pouvais comparer trois familles de modèles dans des conditions identiques.
06 / Trois modèles comparés
Un modèle simple, un réseau de neurones et une forêt d’arbres.
Trace des frontières linéaires entre les types à partir des mesures normalisées. Si elle suffit, inutile d’aller plus loin.
Deux couches cachées avec dropout (neurones désactivés au hasard pendant l’entraînement pour éviter d’apprendre par cœur).
De nombreux arbres de décision, chacun appris sur un tirage différent des données, qui votent. Gère les relations non linéaires sans normalisation.
Les trois modèles ont ensuite été évalués sur les mêmes cinq plis.
07 / Résultats
Le Random Forest est nettement devant ; le réseau de neurones n’apporte rien ici.
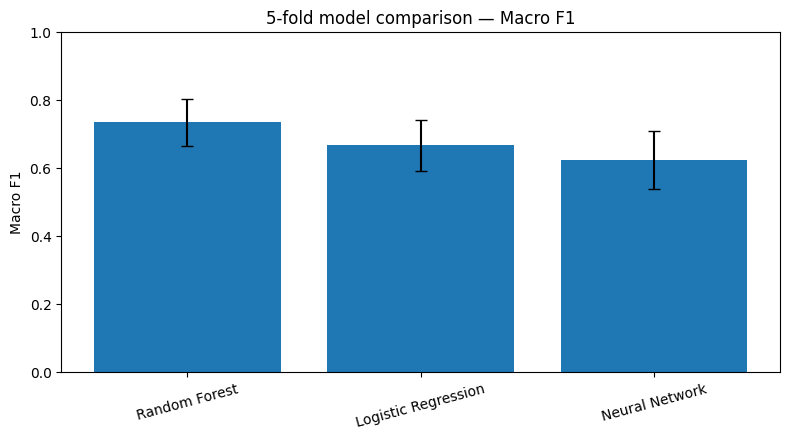
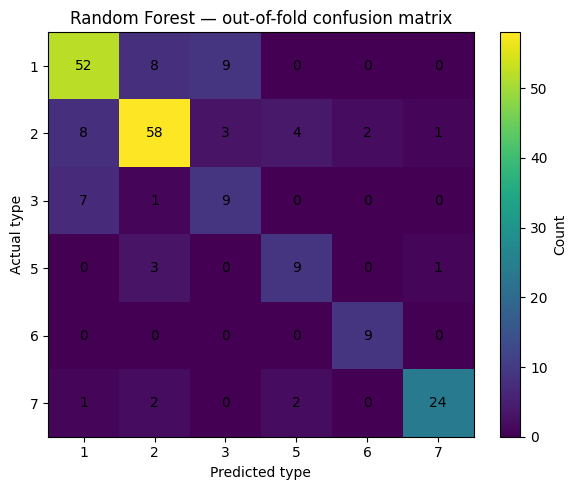
Ces résultats racontent quelque chose sur les données autant que sur les modèles.
08 / Interprétation & valeur réelle
Ajuster la complexité du modèle à la taille et à la forme des données.
Avec 213 mesures chimiques, un réseau de neurones a trop peu d’exemples pour apprendre des frontières fiables, alors que la forêt d’arbres exploite bien des seuils simples comme « peu de magnésium et beaucoup de baryum ». La régression logistique, elle, a une balanced exactitude (accuracy) honorable mais une exactitude faible : elle reconnaît les petites classes au prix d’erreurs sur les grandes.
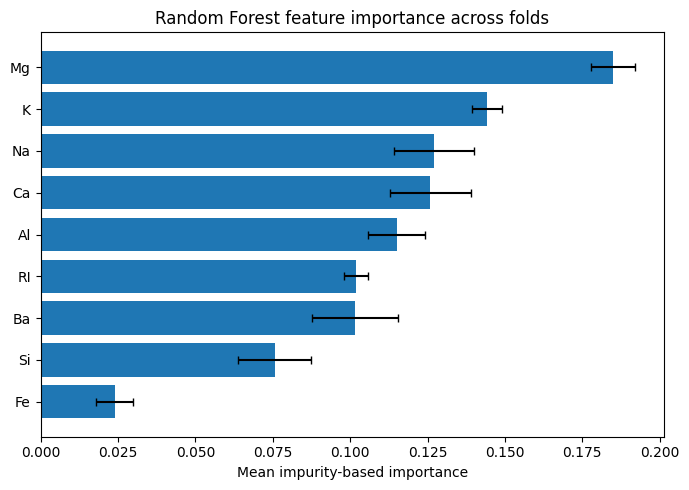
Ce classement décrit ce que ce modèle utilise pour décider ; ce n’est pas une conclusion chimique sur ce qui différencie les verres.
Le modèle peut orienter un expert vers les types les plus probables d’un fragment ; il ne remplace ni l’analyse en laboratoire ni l’interprétation forensique.
Les Types 1, 2 et 3 ont des compositions proches : c’est là qu’il faudrait plus d’échantillons ou des mesures supplémentaires.
Ces conclusions restent bornées par la taille du jeu de données.
09 / Limites & apprentissages
La validation croisée stabilise l’évaluation, mais ne crée pas de nouvelles données.
- Seulement 213 échantillons, dont 9 pour la vaisselle.
- SMOTE aide l’apprentissage mais ne remplace pas de vrais échantillons.
- Aucun jeu de données externe pour confirmer les résultats.
- Aucune revendication d’usage judiciaire ou en production : le modèle peut aider à orienter une analyse, mais ne constitue pas une preuve forensique à lui seul.
Sur un petit jeu de données tabulaires, la méthode d’évaluation compte autant que le modèle. La validation croisée stratifiée et une préparation confinée aux plis donnent des scores modestes mais crédibles ; elles montrent aussi qu’un modèle plus complexe n’est pas forcément meilleur.
Pour aller plus loin
Prochaines étapes envisagées : tester sur un jeu de données de verres indépendant, ajouter des mesures qui séparent mieux les vitres et calibrer les probabilités pour un usage d’aide à la décision. Le notebook détaille chaque étape et ses résultats.