01 / Contexte & question
Un système de détection doit alerter sur les attaques sans noyer les analystes sous les fausses alertes.
Les outils à signatures reconnaissent bien les attaques connues, mais pas leurs variantes. Un modèle de machine learning peut apprendre des comportements : volume de paquets, rythme des échanges, durée, drapeaux TCP.
Réalisé en équipe de trois étudiants ESAIP dans le cours Technical Project en 2024, le projet a obtenu 15/20. Le travail présenté couvre l’analyse des données, la modélisation, l’évaluation et l’application de démonstration, sans attribuer publiquement à une seule personne des contributions qui relèvent du travail d’équipe.
Flux réseau : chaque ligne représente un échange décrit par 64 statistiques CICFlowMeter (paquets, délais, drapeaux TCP, activité). Le modèle joue ici le rôle d’un IDS : il classe chaque flux comme bénin ou attaque.
Question : à partir de ces seules statistiques, peut-on distinguer un flux bénin d’une attaque tout en limitant les attaques manquées et les fausses alertes ?
02 / Ce qu’il faut retenir
Le modèle détecte bien les attaques connues du jeu de données, mais la vraie difficulté reste la frontière entre trafic bénin et Infiltration.
14 540 des 15 872 flux d’attaque du test sont signalés.
1 781 des 10 642 flux bénins sont signalés à tort : encore trop pour un usage direct sans tri complémentaire.
Les autres familles sont presque toutes reconnues à 99,9 % ou plus ; Infiltration ressemble davantage au trafic normal.
Lecture opérationnelle : le score global est bon, mais il masque une asymétrie importante. Le modèle serait surtout utile comme couche de priorisation pour analystes, pas comme décision automatique.
03 / Exploration & contrôle qualité (EDA)
L’EDA explique déjà où l’évaluation pourrait mentir et où le modèle risque d’échouer.
- la répartition des classes : trafic bénin et dix types d’attaques (force brute FTP et SSH ; dénis de service Hulk, GoldenEye, Slowloris, SlowHTTPTest ; DDoS HOIC et LOIC-UDP ; botnet ; Infiltration) ;
- les colonnes constantes et les valeurs impossibles (durées négatives) ;
- les lignes exactement identiques ;
- les flux identiques portant des étiquettes différentes ;
- les ports de destination de chaque classe.
Effectifs ronds par classe : 70 % d’attaques.
27 % des lignes.
Mêmes valeurs, étiquettes différentes.
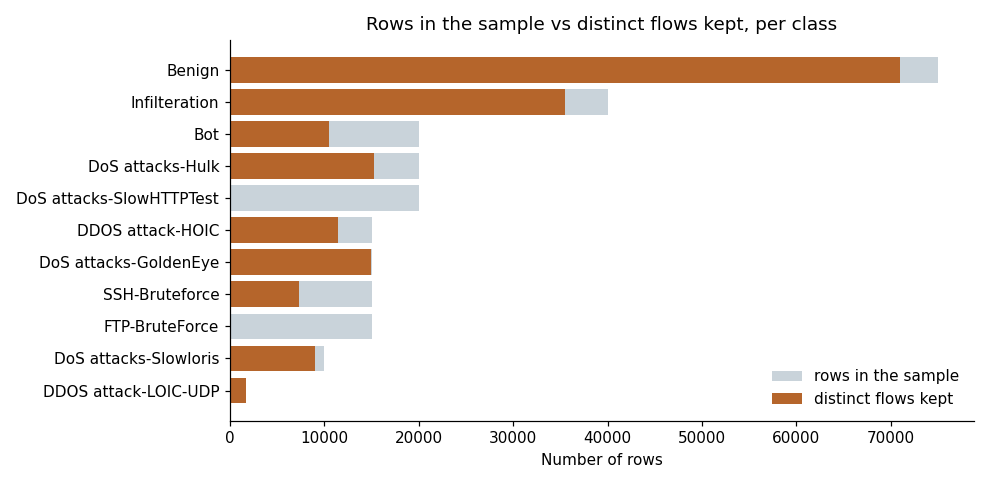
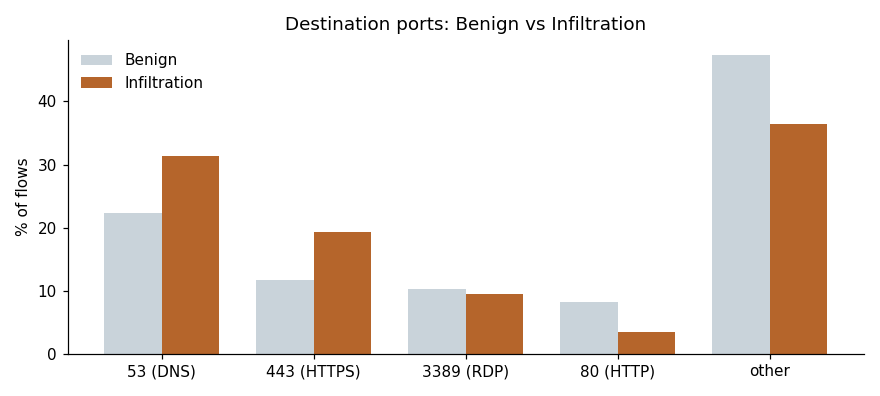
Les doublons doivent disparaître avant le découpage : sinon un même flux serait appris puis « reconnu » au test, et le score serait gonflé. La forte proportion d’attaques (bien plus qu’en réalité) interdit de juger sur la seule exactitude (accuracy). Et la ressemblance entre Infiltration et trafic normal laisse prévoir où se concentreront les erreurs.
04 / Nettoyage
Retirer ce qui fausserait l’évaluation, garder ce qui a un sens.
- suppression des 66 935 doublons exacts ;
- suppression des 3 036 lignes dont les mêmes valeurs portent des étiquettes différentes : aucun modèle ne peut avoir raison sur les deux ;
- suppression d’une ligne à durée de flux négative (erreur de mesure) ;
- suppression de 8 colonnes constantes, qui n’apportent aucune information ;
- conservation de la valeur −1 de
Init Bwd Win Byts, qui signifie « fenêtre TCP non observée » et reste une information utile.
Après nettoyage complet.
Statistiques de flux.
Toujours bien plus qu’en réalité.
Sur ces données propres, il fallait organiser l’évaluation avant d’entraîner le moindre modèle.
05 / Découpage apprentissage, validation, test
Trois jeux séparés, chacun avec un rôle précis.
La validation sert à comparer les modèles et choisir le seuil sans toucher au test. Le test est gardé intact jusqu’à la fin. Le découpage est stratifié pour conserver les proportions des familles d’attaque.
Un contrôle par empreinte confirme qu’aucun flux n’apparaît dans deux jeux à la fois.
06 / Trois modèles, une même règle de jugement
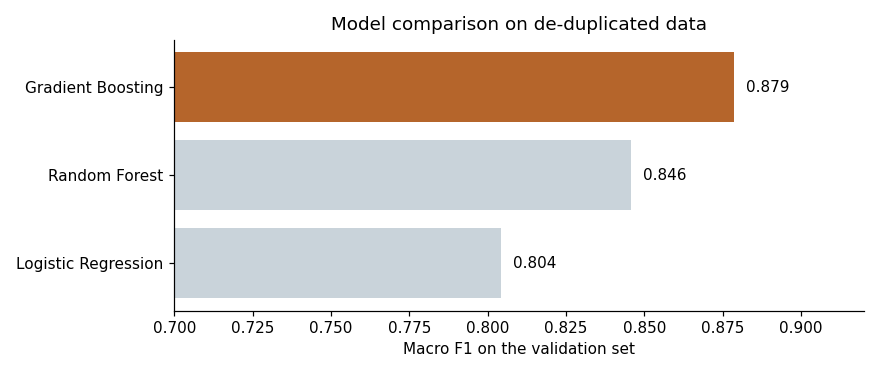
Un modèle linéaire, une forêt d’arbres et du gradient boosting.
Pondère les statistiques pour séparer bénin et attaque par une frontière simple. Les durées allant de la microseconde à la minute, une transformation logarithmique puis une normalisation sont appliquées.
De nombreux arbres de décision, appris sur des tirages différents des données, qui votent.
Des arbres construits les uns après les autres, chacun corrigeant les erreurs des précédents.
Les modèles sont comparés avec trois mesures complémentaires : taux de détection pour les attaques trouvées, taux de fausses alertes pour le trafic bénin signalé à tort, et Macro F1 pour équilibrer les deux classes.
Les transformations et les modèles ne voient que les 123 730 flux d’apprentissage ; leurs réglages sont jugés uniquement sur la validation.
07 / Choix du seuil d’alerte
Le seuil traduit le compromis qu’une équipe de sécurité doit assumer.
Le seuil d’alerte est la probabilité à partir de laquelle un flux est déclaré attaque. Le baisser augmente la détection mais aussi les fausses alertes ; le monter fait l’inverse.
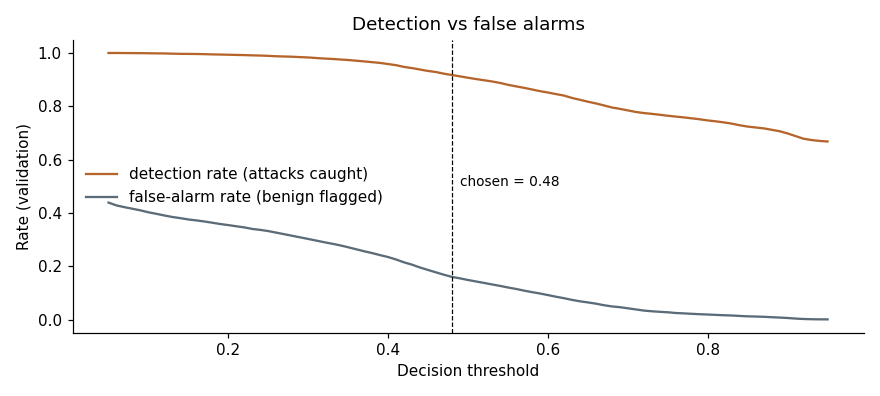
Le seuil retenu est 0,48, le seuil qui maximise le Macro F1 sur la validation. Il a été figé avant toute évaluation sur le test.
08 / Évaluation finale sur le jeu de données de test
Sur des flux jamais vus, le modèle détecte 91,6 % des attaques, mais génère encore 16,7 % de fausses alertes.
14 540 attaques détectées sur 15 872
1 781 flux bénins signalés à tort sur 10 642
équilibre global entre trafic bénin et attaques
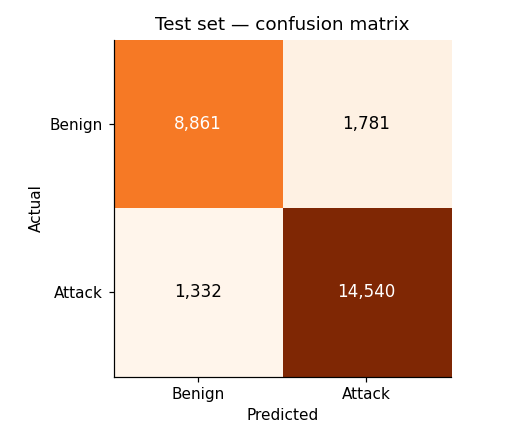
La précision des alertes est de 89,1 % : environ une alerte sur neuf est fausse. Le ROC-AUC atteint 0,964, ce qui montre que le modèle classe généralement les attaques au-dessus du trafic bénin, mais ce score global ne dit pas quelles familles restent difficiles.
09 / Comprendre les erreurs
Le principal problème n’est pas une famille bruyante : c’est Infiltration, parce qu’elle se confond davantage avec le trafic normal.
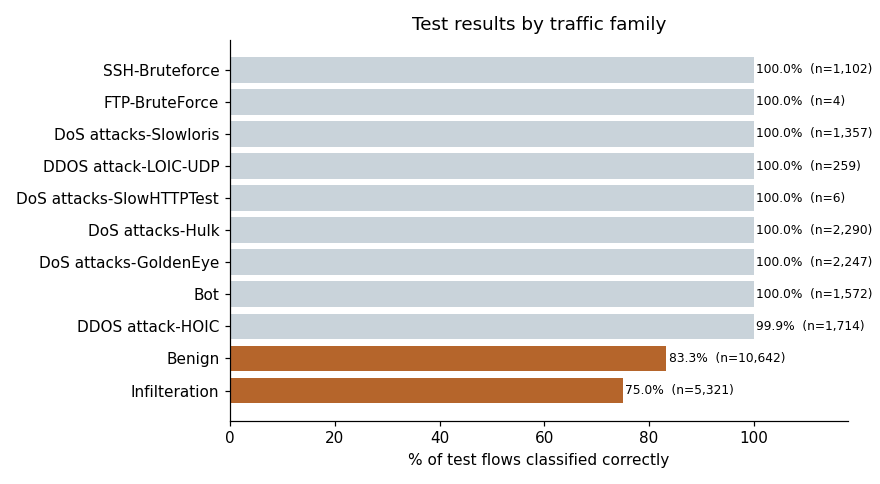
C’est cohérent avec l’exploration initiale : les attaques visant des services très caractéristiques sont faciles à séparer, tandis qu’Infiltration utilise des services également présents dans le trafic normal. Des travaux publiés sur CSE-CIC-IDS2018 signalent aussi des problèmes d’étiquetage ; une partie de l’erreur peut donc venir du jeu de données lui-même.
Le modèle ne dépend pas seulement du port
Sans le port de destination, le Macro F1 de validation baisse de moins de 0,01. Le modèle exploite donc surtout le comportement des flux.
Certaines familles sont minuscules
FTP-BruteForce et SlowHTTPTest ne comptent que 4 et 6 flux de test : un taux de 100 % sur ces classes reste très fragile.
10 / Application de démonstration
Une interface locale pour tester le même modèle et le même seuil que dans l’évaluation.
L’application charge un artefact de modèle contenant le modèle entraîné, l’ordre des 64 variables et le seuil 0,48. Un fichier CSV peut être analysé ligne par ligne, ou le jeu de données de démonstration de 44 flux peut être lancé directement depuis l’interface.
- le modèle rechargé depuis le disque reproduit les mêmes verdicts lorsque les colonnes du fichier sont réordonnées ;
- des contrôles bloquent les colonnes manquantes, valeurs non numériques ou fichiers vides avant la prédiction ;
- l’exécution locale sur les 44 flux de démonstration affiche 38 alertes, 6 flux bénins et 95,5 % d’accord avec les labels fournis.
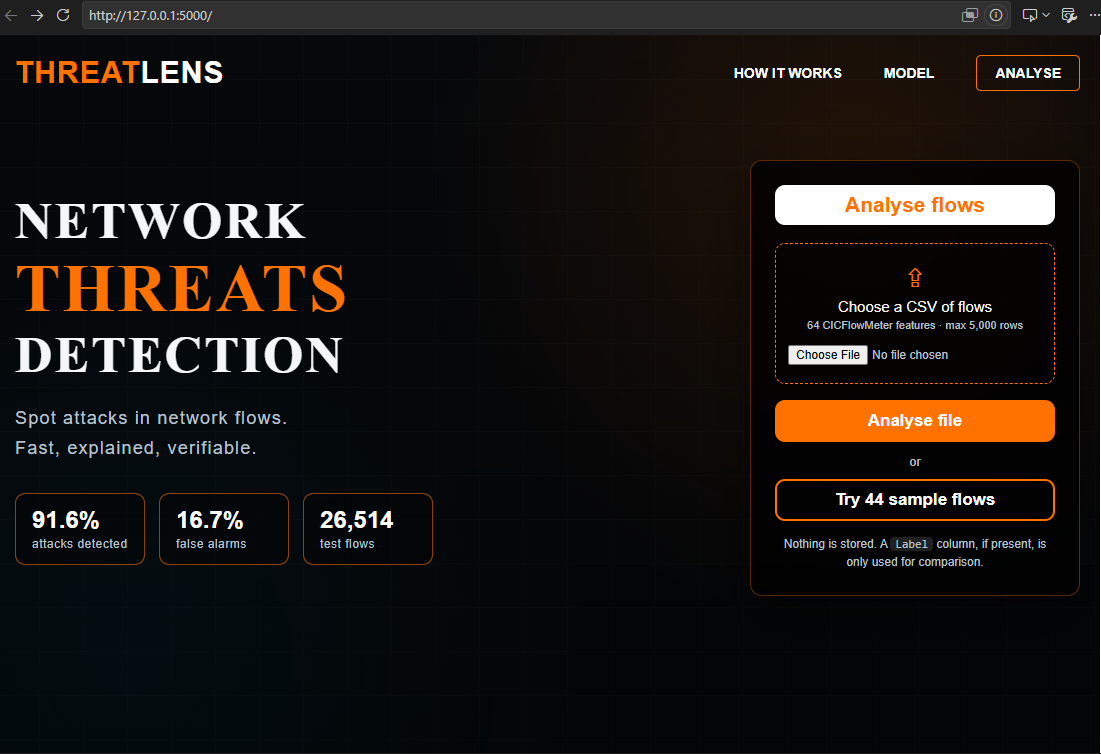
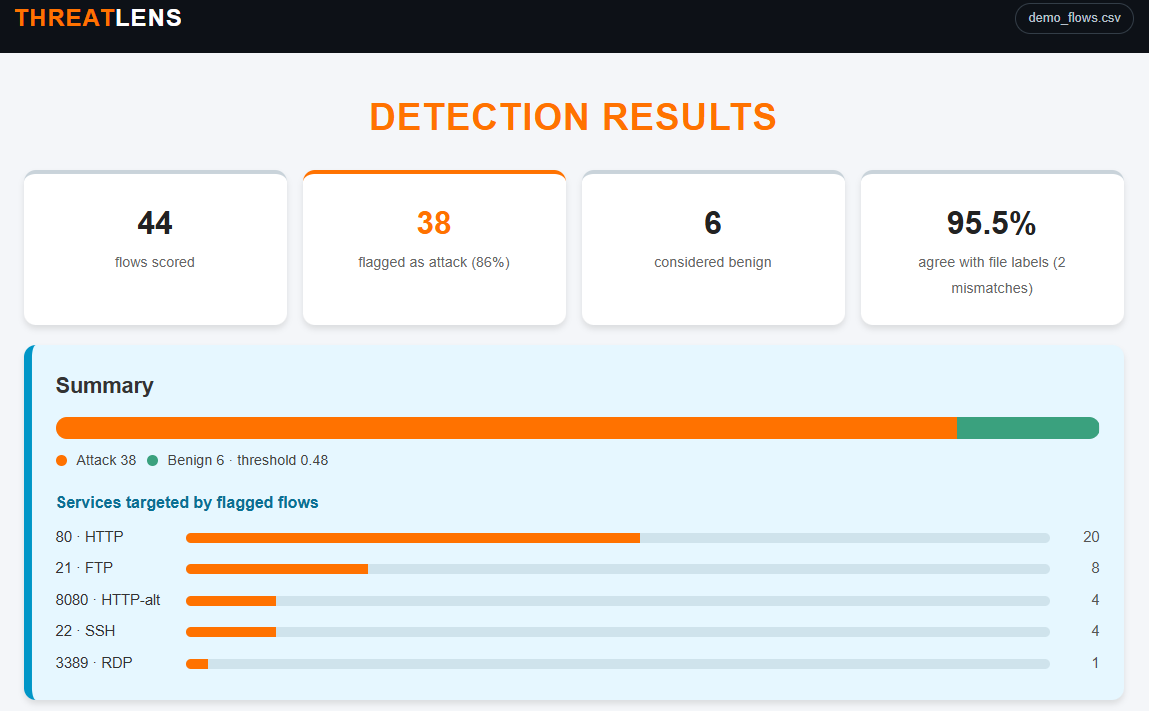
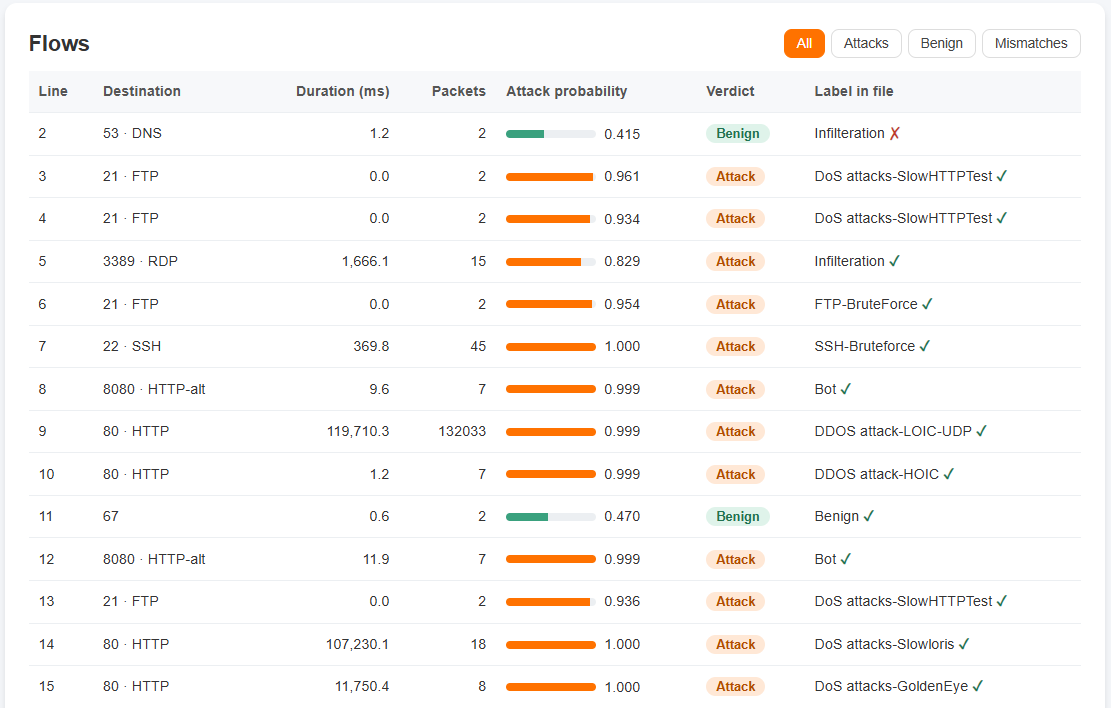
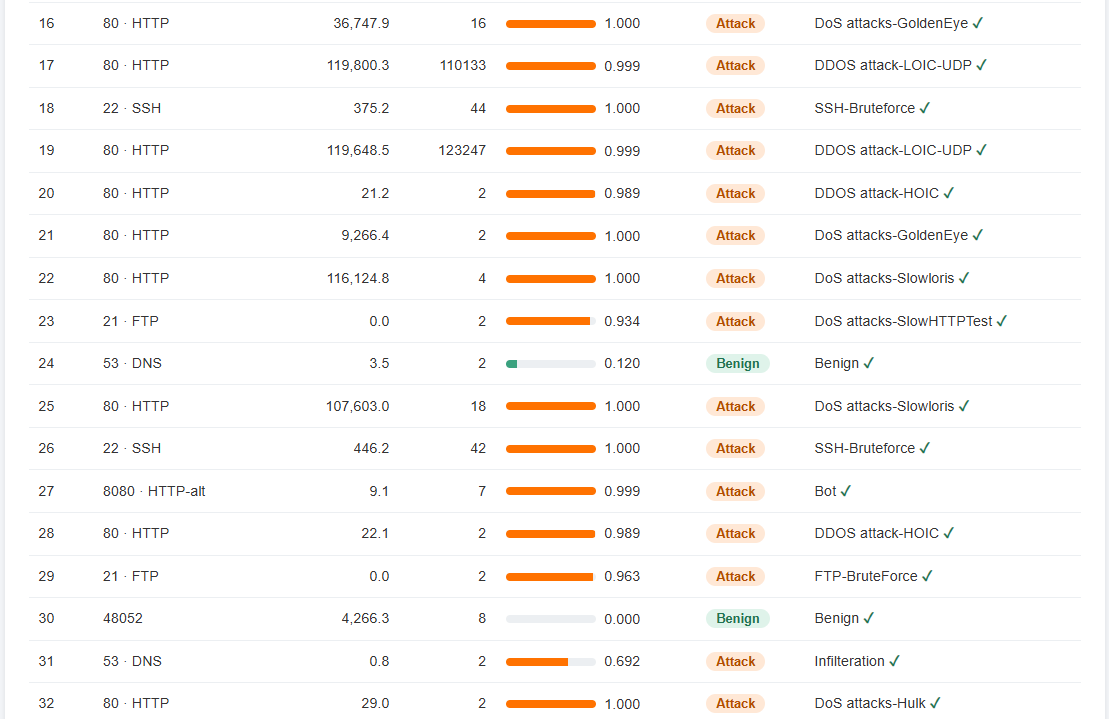
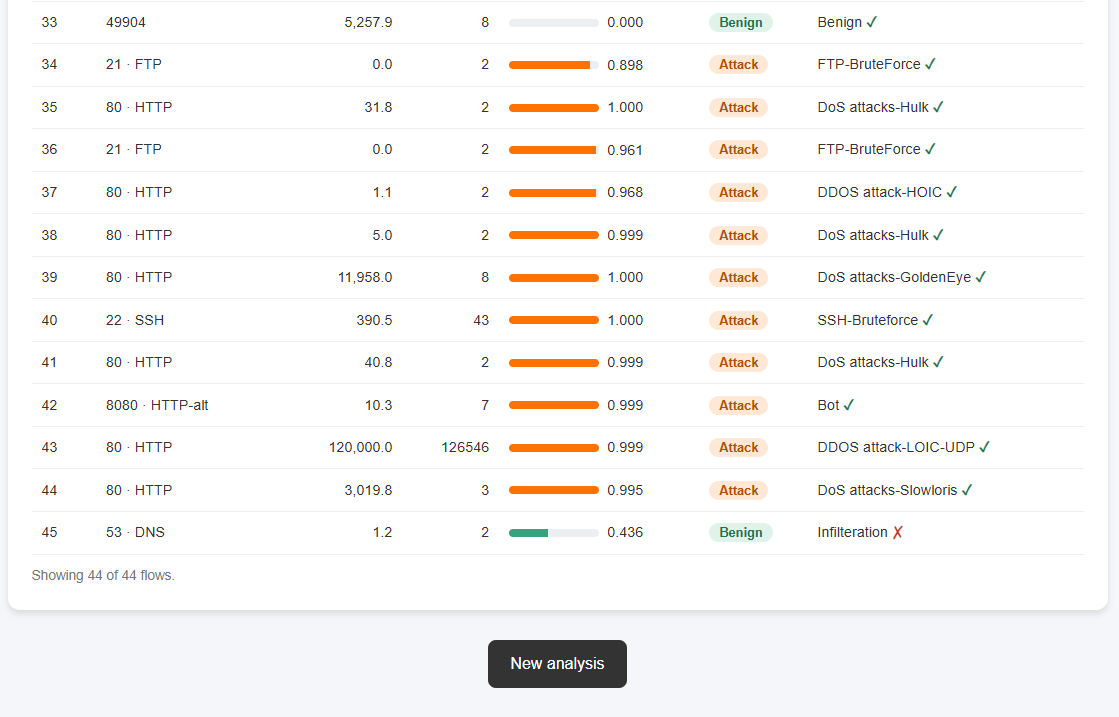
La démonstration Flask fonctionne en local : elle permet de charger des flux CSV et de tester 44 exemples, sans authentification, sans exposition réseau ni surveillance continue du trafic.
11 / Valeur réelle, limites & apprentissages
Un outil de tri pour aider les analystes à interpréter les alertes.
Dans un SOC (centre de surveillance de la sécurité), ce type de modèle servirait de couche de tri : il signale des flux à examiner, en complément des détections à signatures. Le seuil se réglerait selon la tolérance de l’équipe aux fausses alertes, mesurée sur des volumes de trafic réels.
- Flux de référence publics utilisés dans un laboratoire contrôlé.
- Part d’attaques artificielle (60 %) : la précision réelle serait différente.
- Étiquettes d’Infiltration discutables.
- Les statistiques de flux n’existent qu’une fois le flux terminé : pas de détection au paquet près.
- Le trafic n’est pas spécifique aux objets connectés, malgré le cas d’usage IoT envisagé au départ.
Un score n’a de valeur que si les données sont propres et si l’application sert exactement ce qui a été évalué. Cette discipline (contrôler, séparer, valider avant de livrer) est la même qu’en analytics engineering, où une transformation qui s’exécute différemment en production produit des chiffres faux que personne ne remarque.
Pour aller plus loin
Pistes d’amélioration : tester le modèle sur un autre jour de capture ou un autre jeu de données, recalibrer le seuil sur un ratio bénin/attaque réaliste et suivre la dérive une fois en service. Le notebook détaille chaque étape et ses résultats.