01 / Vue d’ensemble
Le même problème se retrouvait aux deux extrémités de la chaîne : trop de données étaient retraitées.
HortiTrace produit des rapports de balance à partir d’un entrepôt PostgreSQL. Lorsque le volume a atteint 6,3 millions de transactions, le rechargement complet et le recalcul du reporting ont commencé à coûter trop cher en temps.
Ne pas modifier les rapports existants.
Les sources ERP, la couche MyReport et les usages des équipes devaient rester compatibles.
Faire moins de travail à chaque cycle.
Réduire les volumes chargés et parcourus plutôt que simplement optimiser une requête isolée.
02 / MyReport en production
MyReport était la colonne vertébrale BI du stage, pas seulement l’outil de restitution.
J’ai travaillé sur plusieurs modules de la suite MyReport BE : de l’alimentation de l’entrepôt jusqu’au suivi opérationnel, à la création des rapports et à leur diffusion. Cette continuité entre ETL, modèle de données et usages BI est l’une des raisons pour lesquelles ce projet correspond aujourd’hui à mon positionnement Analytics Engineering.
MyReport Data
ETL, modèles de sources et migration du chargement complet vers le mode incrémental.
Administrator
Suivi des exécutions, programmation, contrôle opérationnel et administration courante.
Builder
Développement, maintenance et validation de rapports métier dans l’environnement Excel.
Messenger
Automatisation et contrôle de la diffusion des rapports aux équipes opérationnelles.
Page
Création et maintenance de tableaux de bord visuels pour le suivi des opérations.
Center
Consultation et contrôle des indicateurs, tableaux de bord et éléments validés utilisés par les métiers.
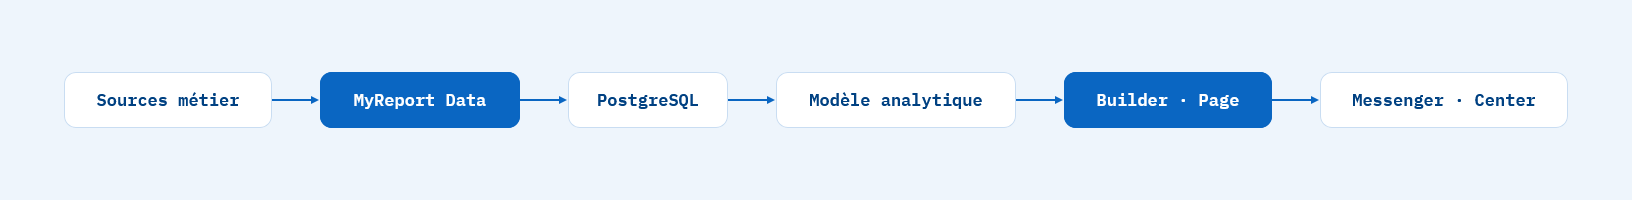
Schéma fonctionnel simplifié, sans informations internes confidentielles.
03 / Diagnostic
L’ETL rechargeait 6,3 M de lignes à chaque cycle alors que seules les données récentes pouvaient changer.
Rechargement complet
~30 minutes par cycle et 6,3 millions de lignes retraitées.
Reconstruction coûteuse des balances
~6,1 millions de lignes parcourues et plus d’une minute pour certains rapports.
04 / Architecture
J’ai séparé la logique d’ingestion, la stabilité de lecture et la couche analytique.
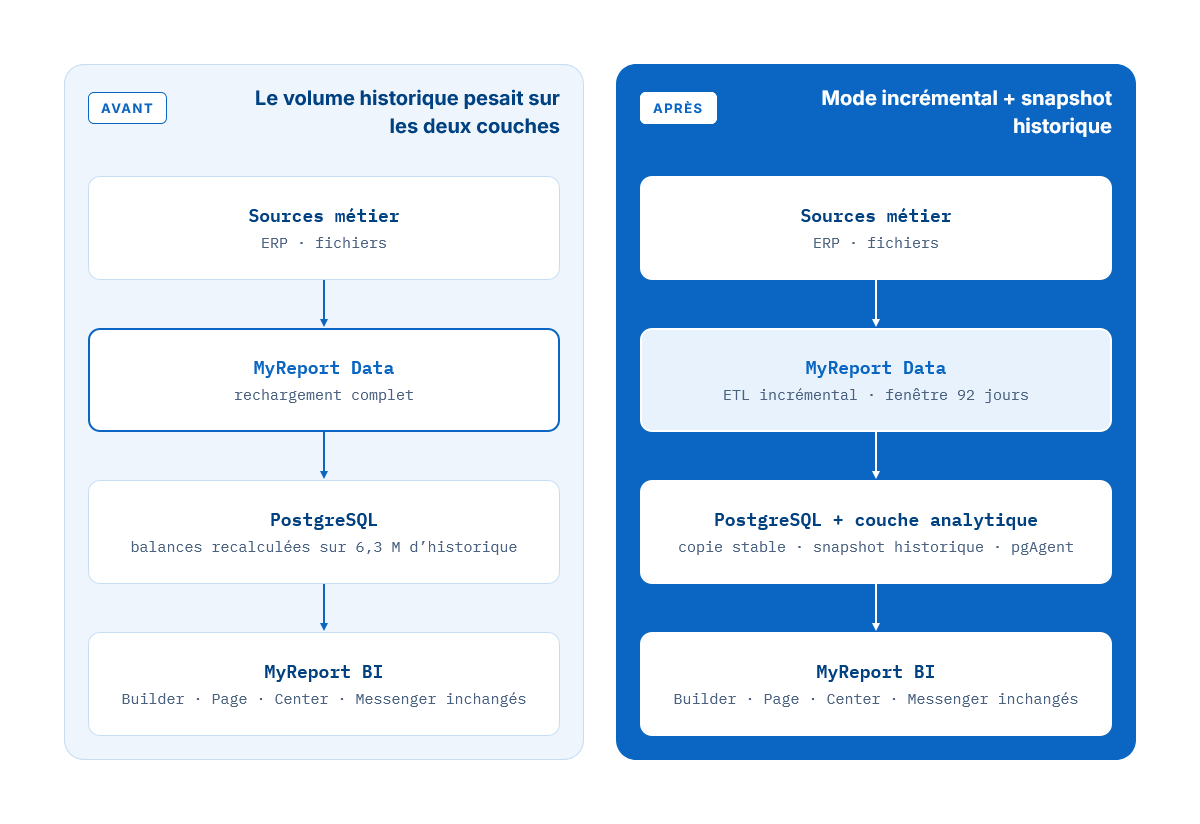
Le modèle de transaction d’origine a été conservé. MyReport Data a été reconfiguré pour charger uniquement la fenêtre récente, tandis que des tables physiques dérivées assuraient une lecture stable et une pré-agrégation de l’historique. La couche de restitution MyReport a continué à fonctionner sans modification des rapports.
L’idée n’était pas de faire travailler le serveur plus fort, mais de lui éviter de refaire le même travail.
LECTURE GUIDÉE · ARCHITECTURE
Deux architectures, un même objectif : des rapports métier inchangés.
Chargement incrémental
Recharger uniquement les 92 derniers jours puisque les enregistrements plus anciens ne peuvent plus être modifiés dans l’ERP.
Copie stable
Construire la nouvelle table dans une zone intermédiaire, puis la substituer d’un seul coup par un renommage atomique, pour qu’aucun rapport ne lise des données à moitié rafraîchies.
Reporting pré-agrégé
Pré-calculer l’historique avant de le combiner aux données récentes afin de réduire fortement le volume parcouru.
05 / Décisions d’ingénierie
Les choix ont été dictés par les contraintes réelles du système existant.
Le coût du rechargement complet augmentait avec l’historique. La règle d’immutabilité du système source fournissait une frontière fiable pour limiter les traitements aux données encore modifiables.
Choix : recharger selon la date de création sur une fenêtre glissante de 92 jours, incluant une marge de sécurité de 2 jours autour de la règle d’immutabilité de trois mois.
Une vue matérialisée aurait été fragile face aux reconstructions hebdomadaires des sources MyReport et à leurs dépendances.
Choix : une table physique séparée, reconstruite de manière contrôlée.
TRUNCATE + INSERT aurait exposé une table vide ou partielle pendant plusieurs minutes.
Choix : construire à côté puis basculer en une opération de renommage.
06 / Pilotage
Autonomie technique, validation partagée et décisions contrôlées.
Développeur principal du projet d’optimisation, j’ai conduit le diagnostic, la conception et l’implémentation avec une forte autonomie, sous la supervision de mon tuteur en entreprise. Les avancées, difficultés et choix techniques étaient discutés lors de débriefings réguliers et de revues hebdomadaires d’environ 30 à 45 minutes.
Ces échanges reliaient les décisions techniques aux conséquences opérationnelles. Les jalons majeurs, les résultats du protocole de validation et le passage en production faisaient l’objet d’une revue avant le Go/No-go.
Diagnostic & design
Mesurer le système existant, identifier les causes racines et cadrer les deux architectures cibles.
Développement & itération
Construire en environnement de test, corriger les écarts et revalider après chaque décision importante.
Validation & déploiement
Appliquer le protocole de sept tests, revoir les résultats avec le tuteur, valider le Go/No-go puis déployer selon l’ordre des dépendances.
Documentation
Maintenir en parallèle les procédures d’exploitation, de renouvellement et de reprise afin de rendre la solution transmissible.
Jalons & dépendances
Suivi dans Notion avec une timeline, des phases, des jalons et les dépendances entre décisions de conception et implémentation.
Jalons de décision
Zéro écart de données comme critère de passage, avec validation avant toute promotion d’un composant vers l’étape suivante.
Registre de risques
Intégrité des données, continuité du reporting et compatibilité de l’outil ETL suivies avec des mesures d’atténuation dédiées.
07 / Mise en production
Une mise en production préparée, vérifiée puis exécutée par étapes.
La mise en production du 3 avril 2026 a suivi une séquence préparée :
- synchroniser les données de test ;
- exécuter les sept contrôles ;
- tenir la revue Go/No-go ;
- déployer les objets dans l’ordre des dépendances ;
- vérifier les données en production ;
- contrôler les rapports ;
- activer enfin les tâches pgAgent.
08 / Validation
La performance n’avait de valeur que si les résultats restaient identiques.
Balances par partenaire
Comparaison des balances pour environ 6 425 partenaires logistiques.
Partenaire × article
Comparaison d’environ 37 500 combinaisons partenaire-article.
09 / Résultats
Le gain vient d’une réduction structurelle du travail inutile.
Zéro écart de balance, aucun rapport modifié et aucune interruption opérationnelle observée pendant la période de suivi après mise en production.
Évaluation & reconnaissance
Deux signaux complémentaires aux métriques techniques : l’évaluation académique du PFE et une reconnaissance directe de l’entreprise.
Note globale du stage de fin d’études, combinant les évaluations de deux superviseurs et la soutenance MSc.
Attribuée par HortiTrace en complément de la gratification habituelle de stage.
Conclusion opérationnelle : le gain ne vient pas d’un serveur plus puissant, mais d’une architecture qui évite de retraiter inutilement l’historique. Les chiffres restent identiques et les rapports existants ne changent pas ; pour les équipes métier, la différence se voit surtout dans des données disponibles plus vite et des rapports beaucoup plus réactifs.
10 / Enseignements
Ce projet résume mon positionnement Analytics Engineering.
Côté ingénierie des données
- Diagnostic des performances
- ETL incrémental PostgreSQL
- PL/pgSQL et pgAgent
- Déploiement et retour arrière
- Validation en production
Côté analyse
- MyReport Data & modèles de sources
- Builder · Page · Center · Messenger
- Pré-agrégation orientée reporting
- Réduction du coût des requêtes
- Mesure de l’impact métier
Confidentialité : le code source appartient à HortiTrace SAS. Cette étude présente l’architecture, les décisions et les résultats sans exposer les noms internes ni les détails propriétaires.