01 / Objectif & résultat global
Comprendre concrètement où vont les données lorsqu’un traitement distribué est lancé.
Le laboratoire assemble Hadoop et Spark avec Docker afin de suivre le parcours complet d’un fichier : stockage HDFS, orchestration YARN, exécution MapReduce, puis traitement équivalent avec PySpark.
Le NameNode reconnaît les deux nœuds de stockage et aucun bloc n’est sous-répliqué lors de la validation.
WordCount puis Average Word Length apparaissent comme FINISHED / SUCCEEDED dans YARN.
PySpark retourne exactement les mêmes comptes que le job Java : hadoop 1, hello 2, world 1.
Ce que le lab démontre : pas un benchmark de performance, mais la compréhension et la validation de deux chemins d’exécution distribués différents dans un environnement reproductible.
02 / Architecture
Deux sous-systèmes dans le même environnement Docker.
Stocker puis exécuter via HDFS / YARN
Les fichiers résident dans HDFS. Les jobs Java MapReduce sont suivis par YARN.
Soumettre un job au master puis au worker
Le WordCount PySpark est soumis au master Spark et lit le fichier depuis le volume partagé.
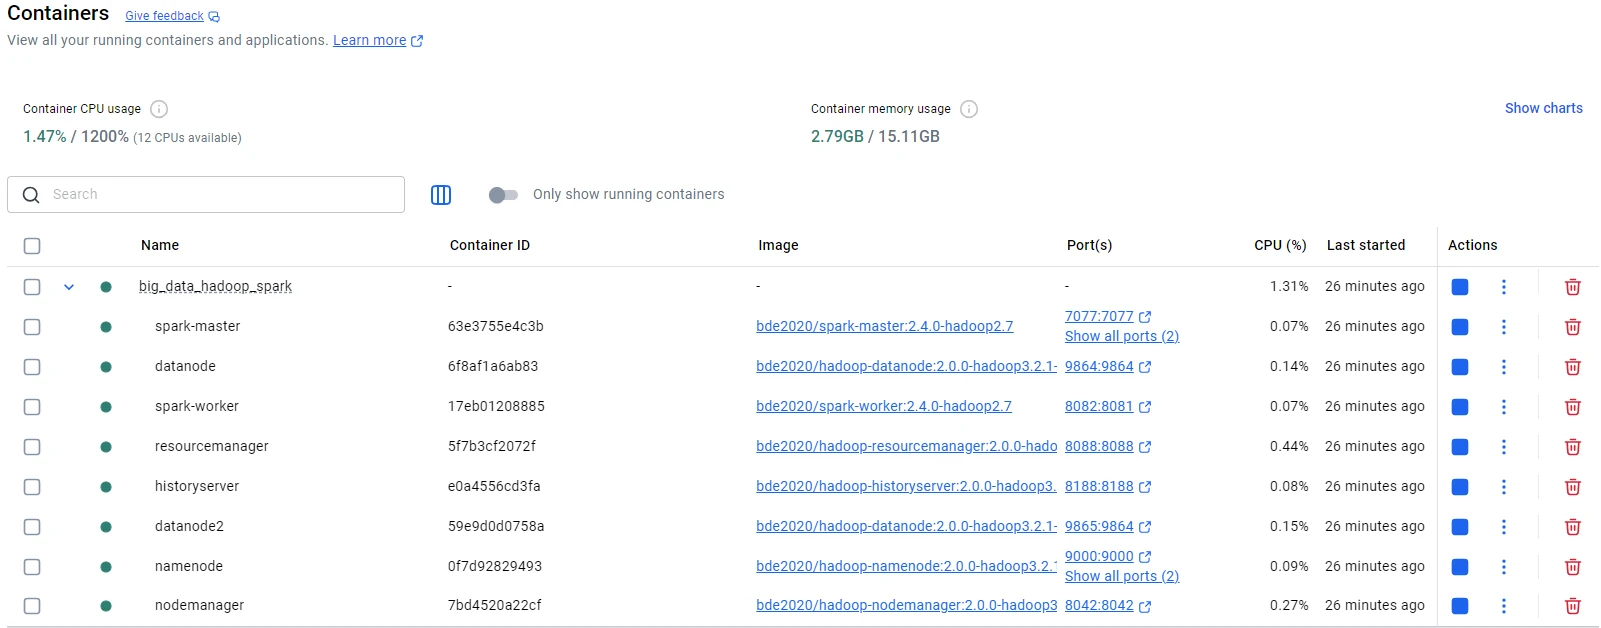
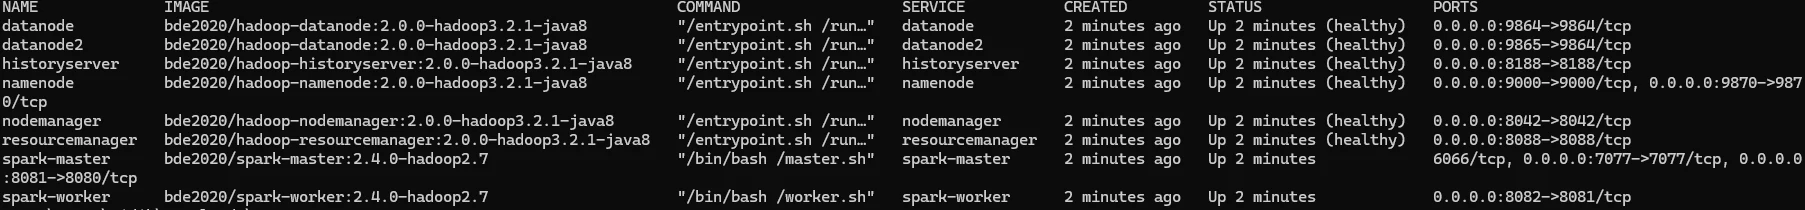
Avec les services actifs, il faut d’abord vérifier que le stockage HDFS voit bien les deux nœuds de données.
03 / Stockage HDFS
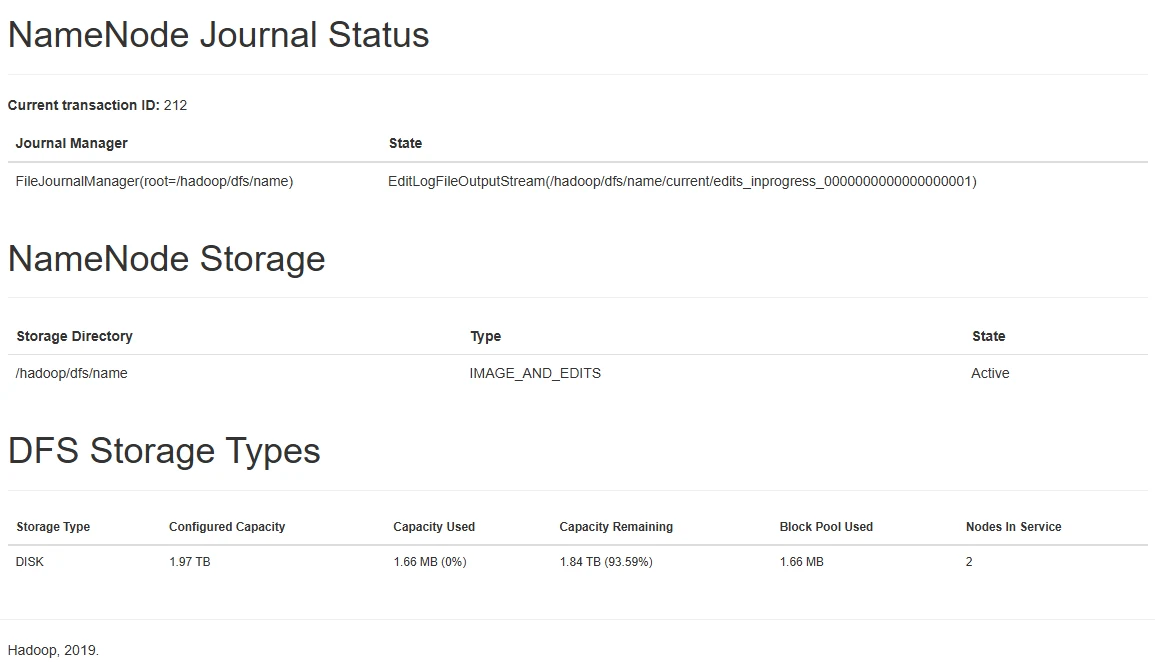
Le NameNode voit deux DataNodes en service.
HDFS sépare les métadonnées du stockage physique. Le NameNode sait où se trouvent les blocs, tandis que les DataNodes conservent les données. Le laboratoire ajoute un second DataNode afin de manipuler cette séparation plutôt qu’un stockage dans un seul conteneur.
Le stockage étant disponible, le premier traitement peut suivre le chemin Hadoop classique : HDFS, MapReduce, puis sortie HDFS.
04 / Java MapReduce
Un WordCount simple pour suivre toutes les étapes du moteur Hadoop.
Le fichier de contrôle contient hello hadoop hello world. Le mapper transforme chaque mot en paire (mot, 1). Hadoop regroupe ensuite les mêmes clés pendant le shuffle, puis le reducer additionne les valeurs de chaque mot.
Chemin Hadoop
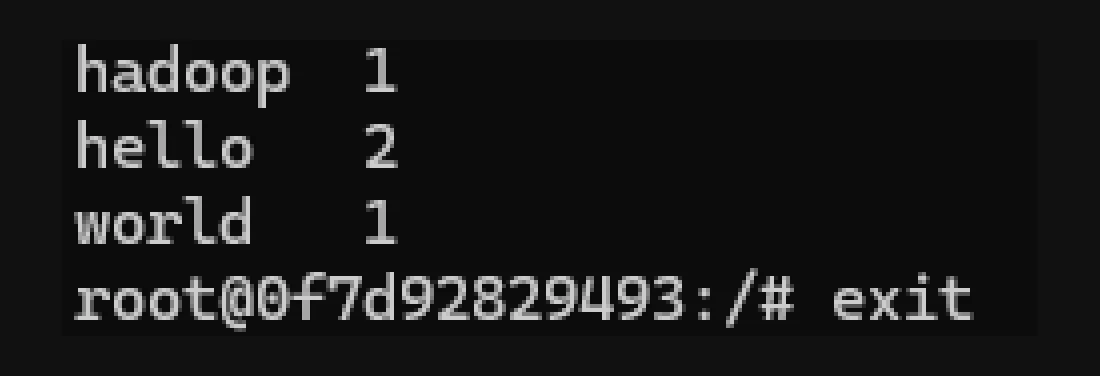
hello apparaît deux fois, hadoop et world une fois.Le résultat devient ensuite un point de comparaison : le même calcul est réécrit en PySpark pour vérifier que la logique reste la même avec une autre API d’exécution.
05 / PySpark
Même transformation, autre moteur d’exécution.
Le job PySpark lit le même fichier depuis le volume partagé. flatMap découpe les lignes en mots, map associe chaque mot à 1 et reduceByKey additionne les valeurs par clé. Le Spark Master délègue l’exécution au worker enregistré.
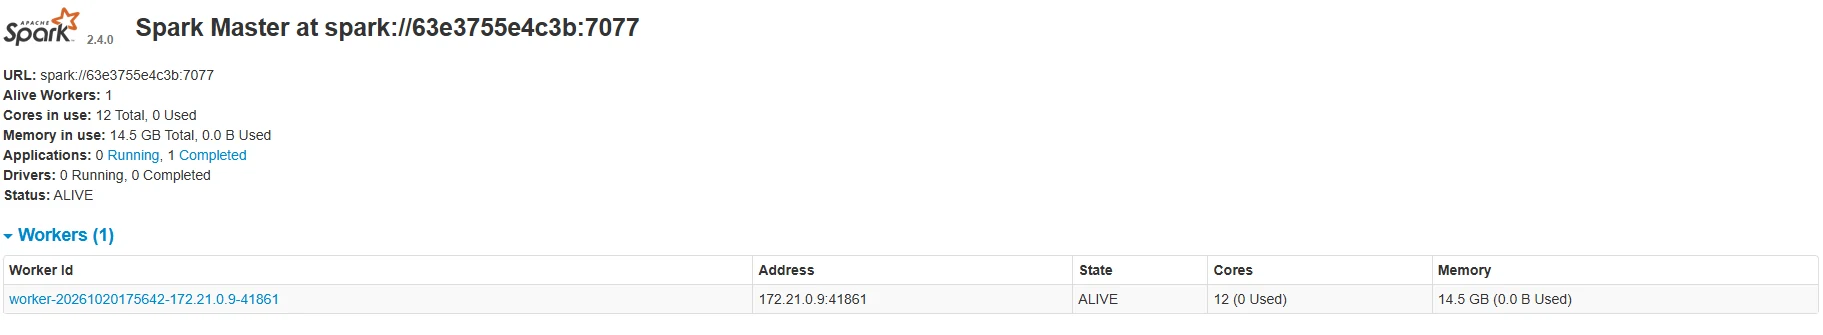
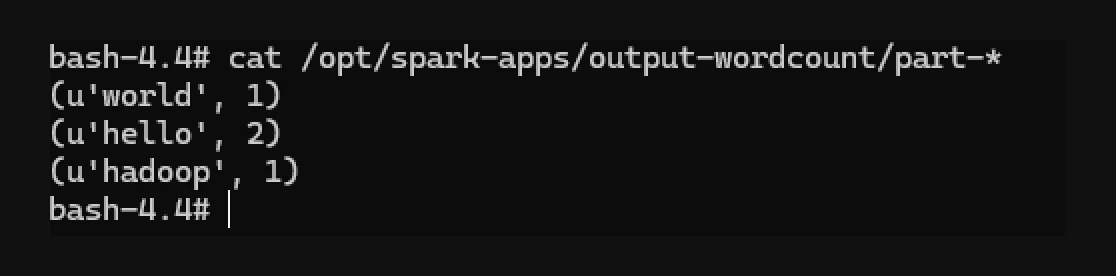
La logique métier est identique, mais le chemin technique change. Le job Hadoop s’appuie sur HDFS et YARN avec du Java MapReduce. Le job Spark est soumis au master standalone et utilise son worker. Ce n’est pas un benchmark de vitesse entre les deux moteurs.
Après ce contrôle fonctionnel, un second job MapReduce permet de tester une agrégation numérique et de rencontrer un problème de type plus concret.
06 / Débogage réel
Le second job échouait conceptuellement parce que le type de sortie déclaré ne correspondait pas au résultat calculé.
Résultat attendu
La longueur moyenne doit être décimale.
Problème
Le reducer écrit un DoubleWritable, alors que le driver déclarait encore un IntWritable.
Correction
Aligner le contrat de sortie du job sur le type réellement produit, puis reconstruire le JAR.
Validation
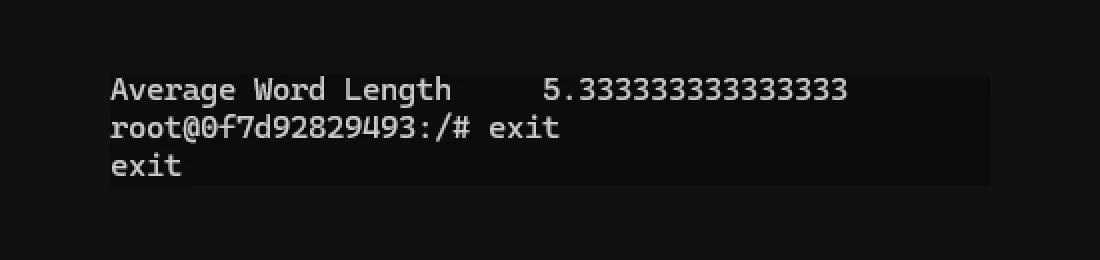
Le job termine dans YARN et retourne Average Word Length = 5,333333333333333.
07 / Ce que les preuves confirment
HDFS, MapReduce et Spark validés sur un laboratoire conteneurisé.
Le point important est la cohérence entre les preuves : les interfaces montrent l’état du cluster, les sorties terminal montrent les résultats, et les deux implémentations WordCount donnent le même contenu. Le laboratoire valide donc une chaîne complète, du stockage HDFS à l’orchestration YARN puis à l’exécution MapReduce et Spark, sans prétendre mesurer lequel des deux moteurs est le plus rapide.
08 / Limites
Un laboratoire pédagogique conteneurisé sur une seule machine.
- Tous les conteneurs tournent sur une seule machine physique : une panne de l’hôte arrête tout le laboratoire.
- Un seul NodeManager et un seul Spark Worker sont utilisés ; le projet démontre l’orchestration et les chemins de calcul, pas la montée en charge.
- Aucun benchmark contrôlé ne permet d’affirmer que Spark est plus rapide que MapReduce dans ce projet.
- Les versions utilisées sont Hadoop 3.2.1 et Spark 2.4.0 dans des images de laboratoire, sans haute disponibilité, Kerberos ni supervision de production.